AI 導入顧問的交付能力,指的是他能不能從需求訪談、驗收標準、Prompt 開發一路做到上線後維運,把 AI Agent 從試辦階段帶到穩定運作六個月以上。 這句定義裡最常被跳過的是最後半段:上線後維運。
先把我們的位置講清楚:Data-DI 自己就是 AI Agent 供應商,旗下有 AltaBots.ai 平台。所以這篇不是中立評測。它是我們把自家交付流程整份攤開來,讓你拿去當比較基準,拿去問別家,也拿回來問我們。
很多企業主第一次評估 AI 顧問,會卡在同一處:四、五家供應商的提案簡報攤在桌上,每一份都有精美的系統架構圖、都聲稱能「客製化」、都附上「成功案例」。但簽約後第六個月,老闆走進辦公室問「然後呢?我們的 AI Agent 上線了沒?效果怎樣?」此時才發現,當初被打動的那些圖表,距離「真的上線並穩定運作」還有一大段路。
也可能你的處境是另一種:Agent 已經在跑了,但沒有人真的在顧。上一家交付完就淡出,窗口每天看到怪的就回報,改完沒人知道到底有沒有變好。這種狀況要換人接手,判準跟第一次導入不完全一樣。本文〈上線之後誰幫你顧〉那一段是為這個處境寫的,你可以直接跳過去。
問題不在於企業沒做盡職調查,而在於評估標準錯了。多數企業比較顧問時,看的是「他們能不能做」(What),該看的是「他們怎麼做、怎麼驗收、怎麼維運」(How)。前者每家都會講,後者只有做過落地的顧問才答得出來。
五階段框架來自我們自己交付對話型 AI Agent 的專案紀錄,主要是客服訓練、業務模擬、面試演練這類「對練型」Agent,那是我們證據最紮實的一塊,所以文中的踩坑現場都出自這裡。要導入對外客服或知識庫問答的話,五階段骨架同樣適用,但具體會踩的坑不一樣,這點先說在前面。
每個階段都附上「會做的顧問」與「只會講的顧問」會怎麼回答的對比。開始之前先給你兩樣東西:一把不需要懂技術也能用的尺,以及那個大家最想知道、卻最少人正面回答的數字:簽約到上線要多久。
你不需要聽懂顧問的技術答案,只要聽得出答案的形狀。 這三個訊號在後面每個階段都用得上。對方講完,回頭對一次。
訊號一:用形容詞代替名詞。 會做的顧問講「我們有錯誤分類儀表板,分四類監控」這種帶結構的答案;只會講的顧問用「我們的服務很完整」「技術很成熟」帶過。形容詞越多,細節越少。這一條你完全不需要技術背景就能判斷。
訊號二:回答得很順,但下一題卡住。 很多顧問把一兩題的標準答案背得很熟(通常是訪談流程與計價這兩題),問到 Prompt 踩坑就轉向「我們會回去確認」「這要看細節討論」,那往往就是能力斷層的位置。
訊號三:反客為主,開始幫你定義問題。 你問「TC 怎麼寫」,對方回「我們會先了解您的需求再給建議」,表面上很客戶導向,實際上是手上沒有可拿出來的範本。會做的顧問會直接說「我們的 TC 範本通常包含三段,要不要給你看一份去識別化的範例?」
這把尺的用法:把它套在後面五個階段的每一題上。你聽不懂對方講的技術內容沒關係,但「他有沒有給出可數的東西」「他有沒有現成的檔案」「他被追問時往哪裡退」,這三件事你判斷得出來。
簡單的資料查詢型 Agent 約 4-5 週可以上線;涉及多角色、多情境的對話型 Agent,從訪談到上線通常需要 2-4 個月,之後還有 3-6 個月的維運陪跑期。 這是我們自己專案的區間,不是業界統一數字,但它至少給你一把尺,去對照其他家報給你的時程合不合理。
會做的顧問願意在報價階段就給區間,而且會告訴你這個區間為什麼會浮動。以下三件事決定你落在區間的哪一端:
變數一:你方的知識庫整備度。 這是最常被低估的一項。如果公司的 FAQ、產品文件、SOP 散落在各部門的雲端硬碟裡、版本互相矛盾,光是整理到可以進知識庫的狀態就會吃掉數週。顧問報時程時如果沒問過這件事,那個時程是猜的。
變數二:你方能投入多少人、多久。 上線前的優化階段一定要你方的人實際操作壓測(後面會說為什麼)。如果窗口是兼著做、每週只挪得出兩小時,測試回饋的節奏就會決定專案節奏。這件事該在訪談階段就談定,不該等到上線前才發現沒人有空。
變數三:Agent 要扮演幾種角色、處理幾種情境。 單一情境的問答型 Agent 跟要模擬多種客戶性格的對練型 Agent,工作量差距是倍數級。
如果你想更細地看試辦階段該怎麼壓縮,可以參考我們寫的 POC 指南:30 天概念驗證怎麼跑。
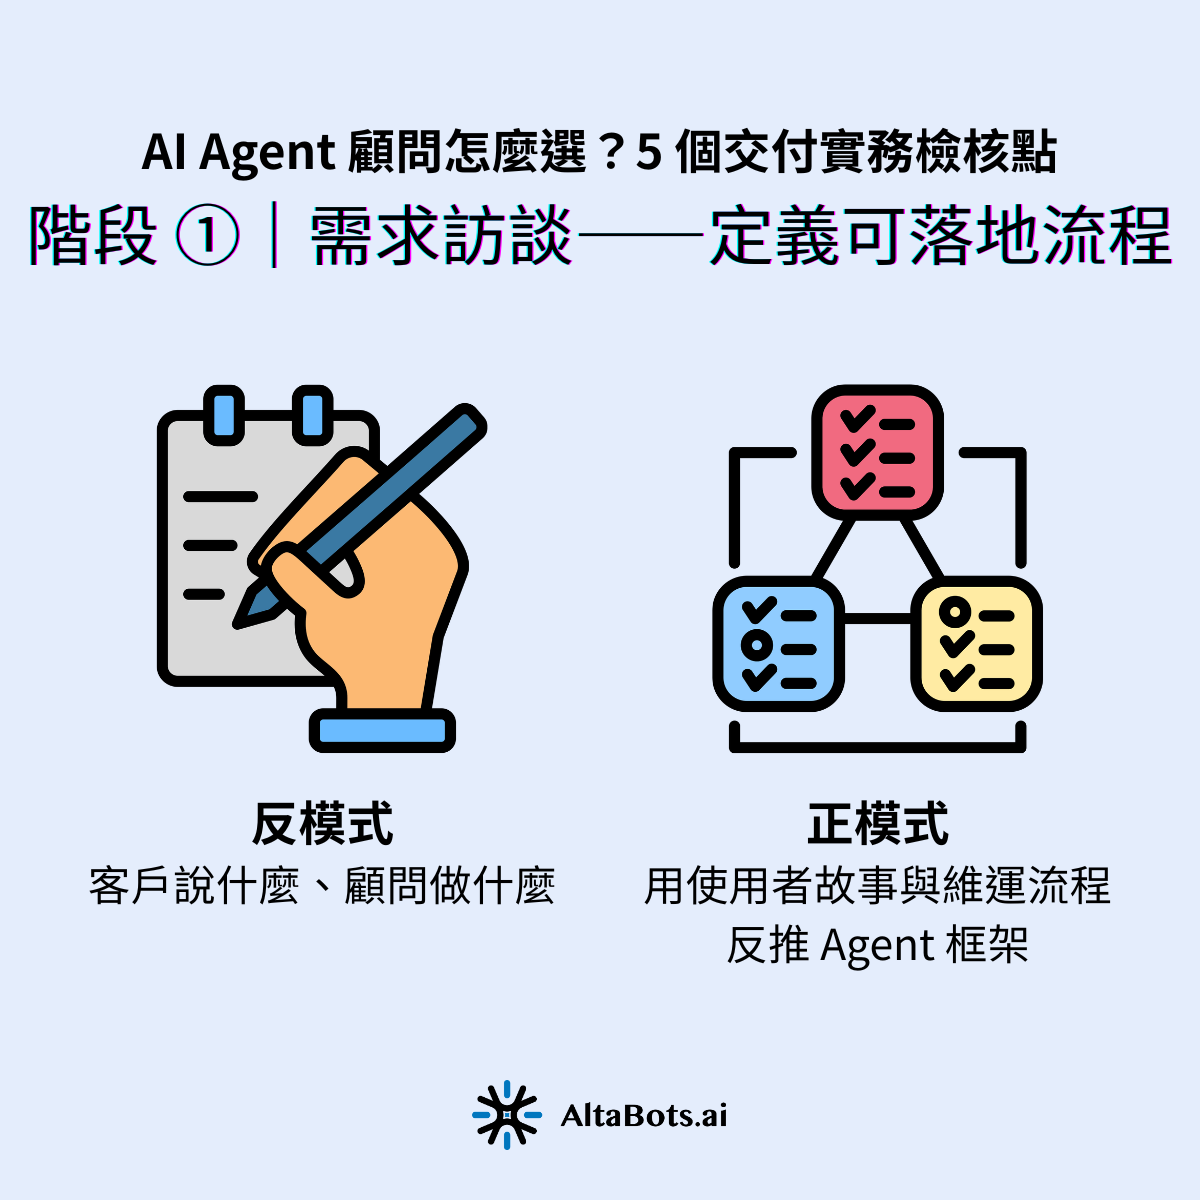
真正會做的顧問,不會問你「想要什麼功能」,而是會問「這個 Agent 上線之後,誰每個月要做什麼?」 這是訪談階段最關鍵的分水嶺:前者把客戶當需求清單來抄,後者把客戶當合作對象,主動定義一套會長久運作的框架。
會做的顧問不會問你「想要什麼功能」,他會問「這個 Agent 上線之後,誰每個月要做什麼?」 這是訪談階段最關鍵的分水嶺:前者把客戶當需求清單來抄,後者主動定義一套會長久運作的框架。
多數企業第一次接觸 AI 顧問時,會誤以為「顧問就是來收需求的」:客戶列功能清單、顧問照單全收回去報價。會議看起來很有效率,這正是日後落地失敗的源頭。
失敗的 AI Agent 專案有個共同特徵:訪談階段顧問完全沒挑戰客戶的需求,把功能描述當成最終規格,回去就開始寫 Prompt。
結果上線後三個月,問題開始浮現:規格只要動一項小條件,整套 Agent 邏輯就要重寫;客戶以為的「彈性」其實是每月都要顧問改 Prompt;沒有人想清楚「新內容進來了、誰要更新知識庫」;出了錯不知道是「使用者問錯」還是「Prompt 該修」。
這時企業會以為是 AI 技術不成熟,更深層的原因則是:訪談階段沒有把「維運」想清楚。AI Agent 是需要每月有人餵新資料、改 Prompt、調知識庫的活系統,訪談階段沒定義出「誰、每月做什麼」,上線那一天就是麻煩開始的那一天。
會做的顧問,會在訪談階段就把兩件事釘死:
第一,定義理想的互動流程。先問的是「使用者打開 Agent 的那一刻、最理想的體驗應該是什麼?三步走完、還是五步走完?」而非「Agent 要有什麼功能」。這個答案決定整套架構,也避免日後做了一堆功能卻每項都被閒置。
第二,把維運規則前置定義。所有會動態更新的內容(新資料、新案例、新 FAQ)全部規劃進知識庫,並寫清楚:文件怎麼拆分、命名規則怎麼訂、資料怎麼切段送進檢索系統(這一項通常叫「向量化」,你不必懂技術細節,只需確認顧問講得出打算怎麼做、以後誰維護)、標籤策略怎麼設,由哪個部門、哪個窗口、每月做哪些動作。Prompt 則設計成「盡量不動」的長期架構。
這兩件事做好之後,企業拿到的會是一份可長期運作的 PRD(產品需求文件),而不是一份「現在很厲害、下個月就要回去找顧問改」的規格書。
如果你正在跟顧問做需求訪談,下面這三個問題會幫你立刻看出對方的深度:

第三題特別重要。成熟的 PRD 會把「使用者怎麼用、何時觸發、知識庫怎麼接、出錯怎麼處理」全部寫清楚——這份文件本身就是經驗深度的證據。拿到之後套上前面那把尺:它是帶結構的具體文件,還是充滿形容詞的目錄?

TC(Test Case,測試案例)是甲乙雙方對「什麼叫做上線可用」的書面共識。 沒有 TC,AI Agent 出了任何錯,沒有人能判斷是 Prompt 該修、是知識庫有缺、還是使用者用法不對,後續維運全部變成各說各話。
多數企業簽約前不會問「TC 怎麼寫」,因為這個詞聽起來很技術。但這正是傳統軟體與 AI Agent 交付最大的差異點:傳統軟體可以用「Pass/Fail」二元驗收,AI Agent 因為大型語言模型具備機率性,相同輸入可能產生略有差異的輸出,確定性測試難以套用 [1]。
換句話說,合約裡沒有 TC,等於沒有驗收標準。
沒有 TC 的專案會陷入三個典型困境:
TC 沒有通用標準,必須依 Agent 屬性調整。做過落地的顧問,會清楚分辨三種寫法:
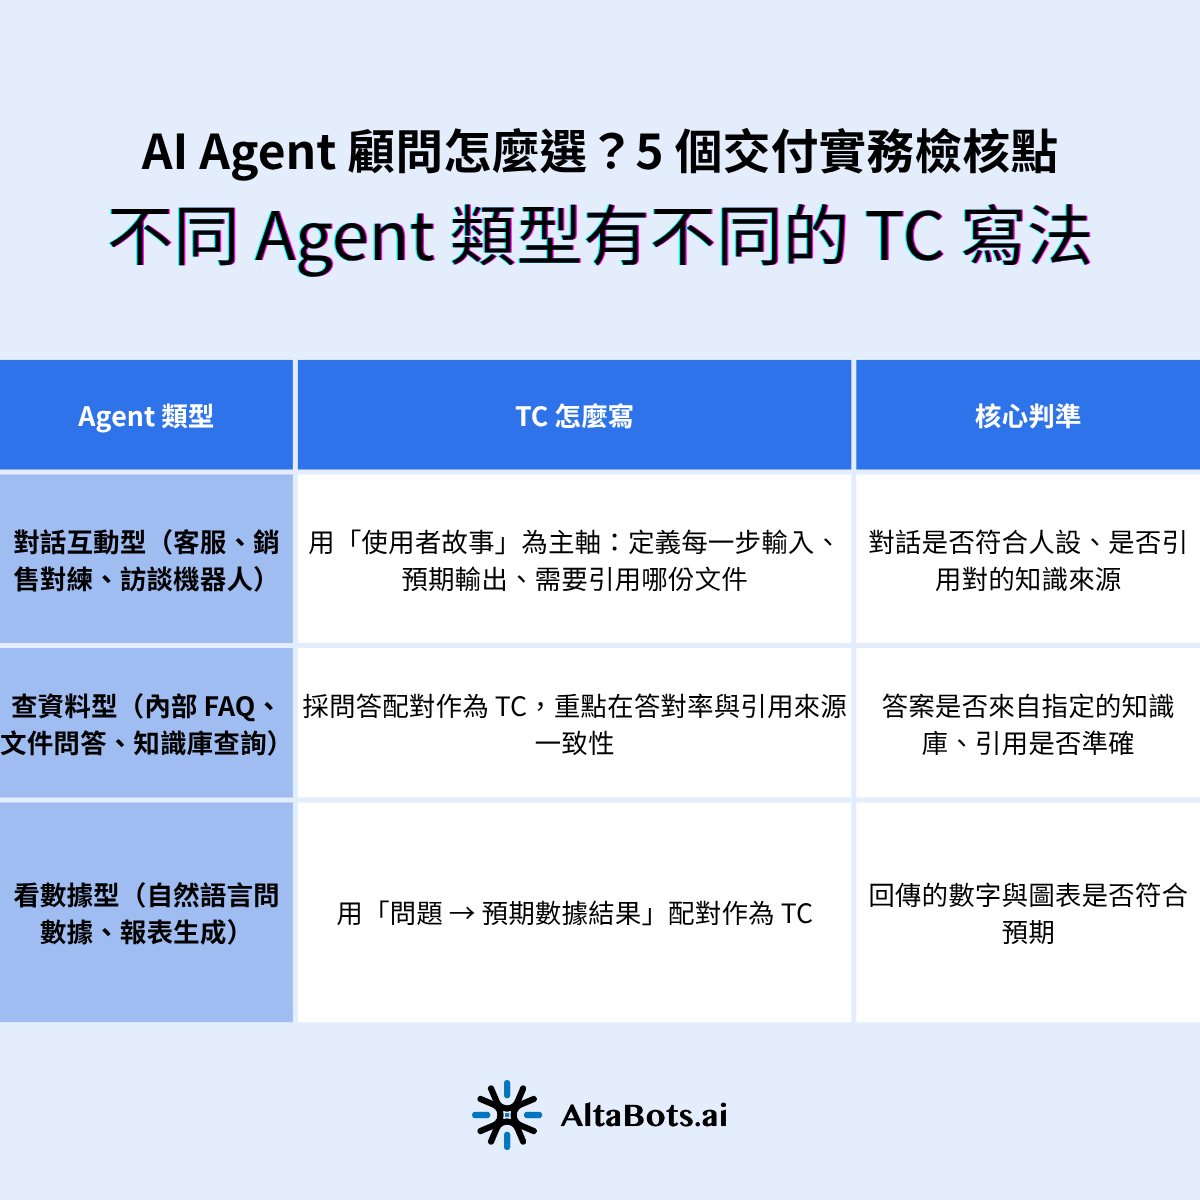
每種 TC 還要再分主流程與邊界案例(Edge Cases)。以我們的專案經驗,上線後的客訴大多集中在邊界案例。顧問願不願意把它寫進 TC,是很實際的分水嶺。
還有一題該問但很少人問:TC 的通過門檻怎麼訂? 輸出有機率性,驗收不會是「一百題全對才算過」。會做的顧問會跟你談出具體答對率,以及哪幾類錯誤屬於「一次都不能發生」的紅線。這個數字談不出來,驗收標準還是空的。
TC 不是一次寫完就定終身。 舉我們遇過的情境:原本 TC 設定「使用者輸入跟主題無關的內容(例如『今天天氣如何』),Agent 應提示此內容非服務範圍」。測試後發現使用者在進入正式對話前很常寒暄,一律拒絕會讓互動變得僵硬。最終 TC 調整為「允許合理範圍內的寒暄回應,並在必要時自然導回主題」。
這類微調屬於「TC 與真實情境貼合」的必要過程,會做的顧問會把它說在前面、寫進交付節奏。順帶提醒:微調要不要另外收費、幾次以內免費,該在合約裡寫清楚。
如果你正在跟顧問談合約,下面這三個檔案是「真實交付能力」的硬證據:

第三份最難造假。它代表對方跑過完整交付週期,而且願意讓你看見自己改過規格。三份都拿不出來,往往代表對方還停在「先做出來再說」的階段。

顧問講不講得出失敗,比講得出多漂亮的成功更有參考價值。
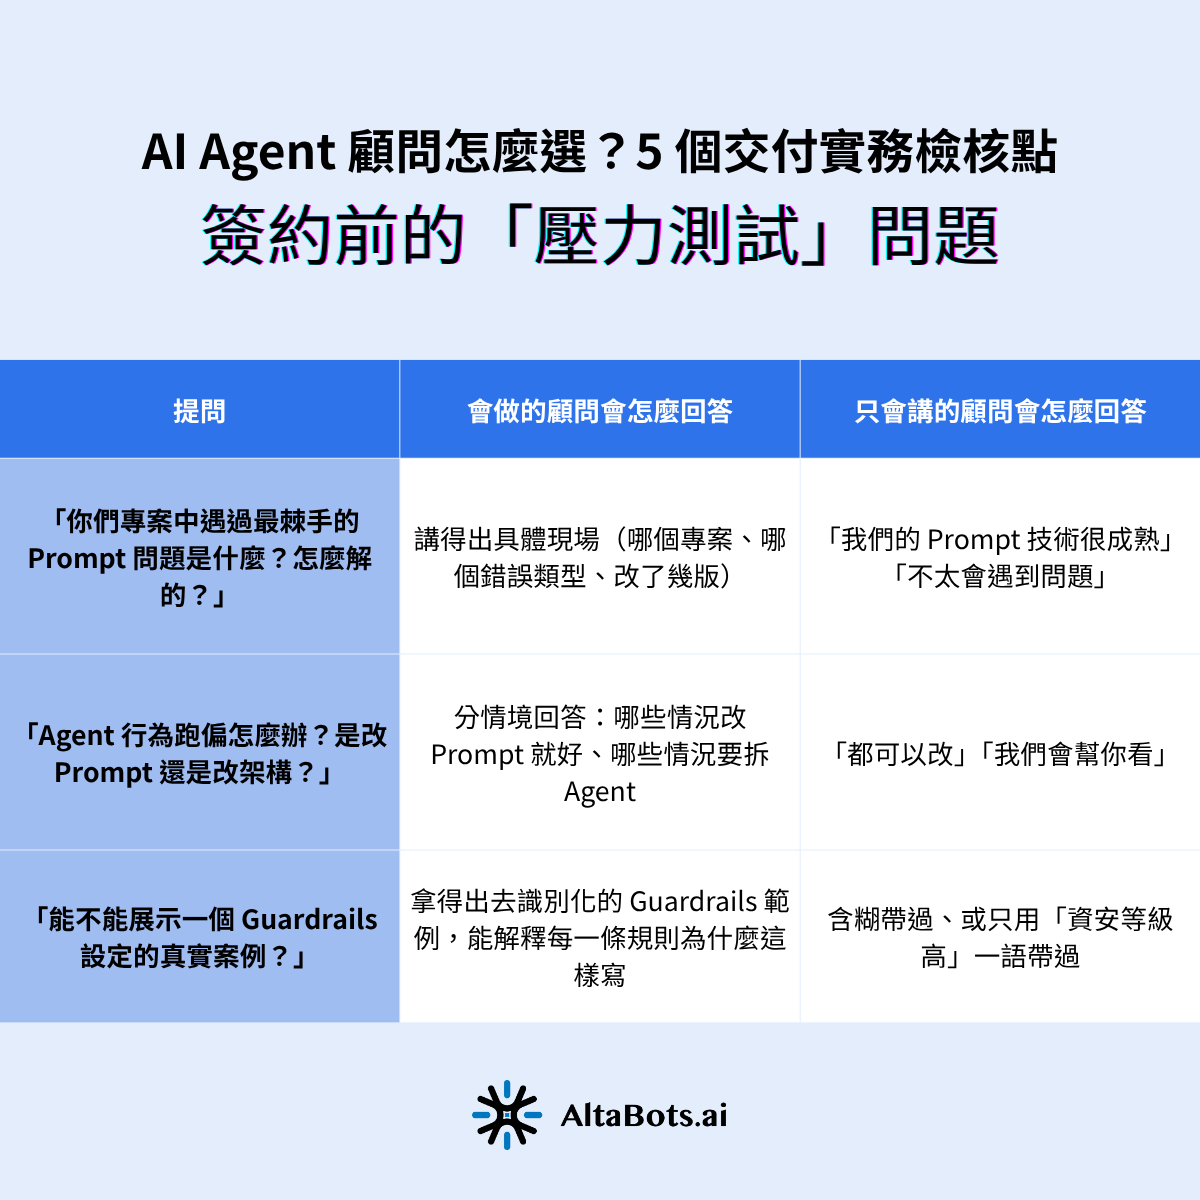
大型語言模型的行為不完全可預測,幾乎所有對話型 Agent 都會踩到類似的坑,差別在於有經驗的顧問能在客戶察覺之前就解掉,沒經驗的顧問會把坑當功能交付給你。所以最有效的做法是請他現場講一到兩個踩過的坑。你不需要聽懂技術解法,只要用前面那把尺聽形狀:他講得出具體現場(哪個專案、第幾輪對話、怎麼發現的),還是只給你「這個我們都有處理」?
下面三個是對練型 Agent 最常見的踩坑現場。
Prompt 裡明明定義「使用者是客服人員、Agent 扮演來電客戶」,跑沒幾輪,Agent 就忘記自己是誰,反過來扮演客服、開始幫使用者解答。面試模擬 Agent(應該提問,卻變成幫應徵者準備答案)、銷售訓練 Agent(應該扮演被推銷的買家,卻變成幫業務想話術)也一樣。原因是大型語言模型在訓練時被預設為「提供幫助的那一方」,你要它扮演被服務的角色,等於跟它的預設行為對著幹。
同一族的第二種症狀是人設隨對話變長而淡掉:設定「資深採購主管、風險偏好保守、對品質很挑剔」,前三輪表現得很好,到第八輪、第十五輪就突然變得很爽快、什麼都同意。
這兩種都是結構性現象,不是設定沒寫好。解法屬於實作層,你不需要能自己做,但要問對方怎麼解,因為這一題照著文件抄不出答案。對方說得出「我們在 Prompt 的哪個位置怎麼釘、第幾輪做了什麼、花多久穩定下來」,並拿得出去識別化範例,就是做過;答「這個要看情況」或「模型能力問題」,就是沒有。
同一組根因會長出三種症狀:
根本問題是模型不知道自己該知道什麼。會做的顧問會交出一份「對話場景邊界規則(Guardrails)」清單,明列哪些行為允許(合理寒暄、自然導回主題)、哪些禁止(討論與情境無關的話題、講出系統內部設定)。這份清單是可以索取的實體文件,那就是你的檢核點,不必懂它怎麼寫成的。
對話型 Agent 有個結構性取捨:使用者投入越多前置設定,對話彈性越高、體驗一致性越差;投入越少,劇本越穩定,久了會像在背劇本。會做的顧問依「使用情境是否需要明確目標」決定走哪條路,並且先讓客戶理解這個取捨,避免事後才發現「為什麼上週測得很好、這週又不行」。
這題對你特別有用,因為判準不在技術層:你只需要觀察對方有沒有主動把取捨講在前面。願意講取捨的顧問,通常也願意講風險與失敗;開口就說「我們什麼情境都能處理」的,你手上的尺會自己響。
下次跟顧問見面,可以丟下面三個問題:

AI Agent 上線不是專案結束,而是真正開始。 沒有評估機制的維運,等於開飛機沒有儀表板。
傳統軟體上線後只要不改規格,行為不會自己變。AI Agent 不一樣:底層模型會更新、知識庫會擴充、使用者問法會演化。少了持續監控,它會慢性失控。這是篩選顧問的最後一關,也是各家價差最大的一段。
如果你手上已經有在跑的 Agent、想換人接手維運,這一段就是你的判準來源,直接拿下面三個檢核點去問接手方。
很多顧問會在上線前自己跑一輪測試,覺得通過就交付。這是典型的「只會講」做法。
會做的顧問會這樣做:上線前一定讓客戶方的人親自操作壓測,異常記為 issue case,然後做兩件事:依真實異常調整架構或 Prompt;把 issue case 分類、定義頻率與影響程度,整理成上線後的監控指標庫與成功標準(success criteria)。客戶動手測之前,心中對 Agent 的要求是模糊的;只有操作過,才說得出「我期待的反應應該長這樣」。顧問跳過這一步,等於把維運責任全推給客戶。
順帶釘一件容易吵架的事:合約裡的 TC 與上線前測出的 issue case,哪一個是驗收依據? 通常做法是 TC 為驗收基準、issue case 作為上線後監控指標的來源。沒寫清楚,這裡就是日後爭議的入口。

反模式:「窗口看到什麼改什麼」。 客戶端的窗口(行銷主管、客服主管、IT 主管)每天看對話紀錄,覺得哪一筆怪就回報、顧問就修。聽起來很客製化,卻有三個致命問題:沒有錯誤類型統計,分不出某個錯誤是偶發還是結構性,可能改掉眼前這筆、漏掉同類型的一整批;沒有優先順序,所有 issue 看起來一樣重要,最後變成打地鼠;沒有可衡量的改善,修完之後沒人知道是真的變好,還是換了一種錯法。
正模式:方法論式的評估陪跑。 這套作法在公開的 Agent 工程資料裡已有成形的方法論 [1][2],核心是四個步驟:
四類錯誤的名字你不必記,但你可以要求對方給你他的錯誤分類表。分得出類、講得出各類佔比,代表他在做;只講「我們會持續優化」,那把尺又響了。
評估維運陪跑能力,有個很直觀的是非題:這家顧問有沒有提供「監控 Dashboard」,而且能不能現場 demo?
Agent 錯誤分析與 Evals 陪跑 看起來技術門檻很高,本質則是「持續品質保證」服務,包含 Dashboard 設計、用模型評審模型輸出的監控機制、Agent 架構調整建議(例如「這支 Agent 該拆成兩支」)、知識庫重整與檢索策略優化。
你不需要判斷對方有沒有這些能力,要求現場 demo 一個真實的 Dashboard 就好。自己做的和外包的、有的和沒有的,在 demo 現場分得出來。這也是為什麼這道題比任何技術問答都有效。

第三條最容易被跳過,也最容易在第四個月變成爭議。簽約時問清楚,比上線後談判省力得多。
如果會議時間有限,優先問這 5 題,剩下的對方會自己暴露。
安排一場 30-45 分鐘的會議依序丟出去。會做的顧問會自然展開細節、講案例、講取捨;只會講的通常從第 3 題開始閃躲,把話題拐回「我們的優勢」。

只能問一題的話,問第 3 題。 關鍵不在答案對錯,而在對方講不講得出失敗。會做的顧問講失敗很自然,沒真的踩過的人會本能閃躲。
擔心對方口才好、當場編一個踩坑?把三個閃躲訊號疊上去:要他給出可數的東西(第幾輪、幾類錯誤、花多久),要他拿出去識別化的檔案。故事編得出來,檔案編不出來。
想看更完整的落地脈絡,可參考 導入 AI Agent 前必知的 5 大風險,或瀏覽 Data-DI 其他 AI Agent 導入實戰指南。
你買的不是 No Code 平台,是「能上線的結果」。
前面說過我們的位置,這裡把話講完。AltaBots.ai 是 Data-DI 的企業級 AI Agent 平台,差異化在「從決策到上線,顧問全程陪跑」的雙軌交付,而非 No Code 工具本身。 市場上多數平台走兩條路之一:純 SaaS 工具(買了自己用、出問題自己查文件),或純顧問服務(顧問規劃、工具外包、整合性差)。我們走第三條:平台與顧問深度整合,前面五階段的每個檢核點都在交付流程裡標準化執行。

這份對比的用途是讓你判斷你需要的是工具,還是陪跑到有結果。團隊已有完整落地經驗、只缺 No Code 工具的,純 SaaS 就夠,不必多付顧問費;第一次導入、或前次導入失敗想重來的,雙軌陪跑務實得多;純試用、預算極低的,免費工具更適合你。
順帶說明我們為什麼不把 No Code 當主賣點:它解決的是「誰來寫」,沒解決「該寫什麼」。 Agent 會不會落地、半年後還能不能用,跟 No Code 無關,跟前面五階段的交付能力高度相關。
這篇要求你去索取供應商的去識別化檔案,那也該適用於我們。你可以在評估會議上直接要這三份,跟你要其他家的一模一樣:
我們的客戶名稱與成效數字受合約保密,不會出現在公開文章裡,所以請不要用「他們說自己做過很多案子」來評估我們。用上面三份檔案評估,那才是可驗證的東西。同樣的標準,請套用在你桌上的每一家。
如果你的情境符合前面說的前三項,預約一場免費 AI Agent 導入評估諮詢——30 分鐘,出席的是實際會接你案子的顧問而非業務,會依你公司目前的階段、預算、團隊配置,判斷雙軌陪跑能不能解你現在的問題。
回到開頭的情境:四、五家提案簡報攤在桌上,每一份都看起來很厲害。現在你手上有判斷工具:看誰講得出失敗、講得出細節、講得出取捨,而不是看誰的簡報最精美。
五個交付階段(訪談、TC 設計、Prompt 開發、上線前優化、上線後維運陪跑)每個都是篩選器。做過落地的顧問,每個階段都答得出具體執行細節,因為那些細節是踩過坑、被客戶罵過、修了很多版才換來的。沒做過的會講方法論、講願景、講「我們很專業」,細節問下去就開始閃躲。
而如果你連技術答案都聽不懂,沒關係,那三個閃躲訊號就夠用了。形容詞的密度、被追問時退往哪裡、手上有沒有現成的檔案,這三件事不需要任何技術背景。
你採購的,本質上是顧問接下來六個月、一年要陪你跑的能力,不是當下的那一場簡報。
如果你正在評估 AI 導入顧問,或想先確認自己公司目前的階段適合哪種合作模式,歡迎用上面那五題來問我們。
[1] Simon Liu(2025). DevOps in AI Agent | 評估 AI Agent 是否能夠上線的測試功能介紹 — Google ADK AI Agent Evaluation 概念介紹篇. Medium.
https://medium.com/@simon3458/adk-ai-agent-evaluation-intro-1-2025-2182627bb775
[2] Build School Learn(2026). AI Agent 評估 Evaluation 全解析:從 Demo 到可上線系統的關鍵方法論(Anthropic 實戰指南).
https://learn.build-school.com/from-demo-to-production-ai-agent-evaluation/
[3] Data-DI(2026). AltaBots.ai 內部專案紀錄. 本文中 4 個 Major Issue(角色錯亂、人設漂移、防禦邏輯、彈性穩定性權衡)與五階段交付方法論,來自 Data-DI 在多個對話型 AI Agent 落地專案中的實戰經驗整理,已去識別化處理。